Site is under maintenance. Please login, thank you.
TnT (Trigrams'n'Tags)
- Last Updated: 12/5/2013 12:00:00 AM
- Site: http://www.coli.uni-saarland.de/~thorsten/tnt/
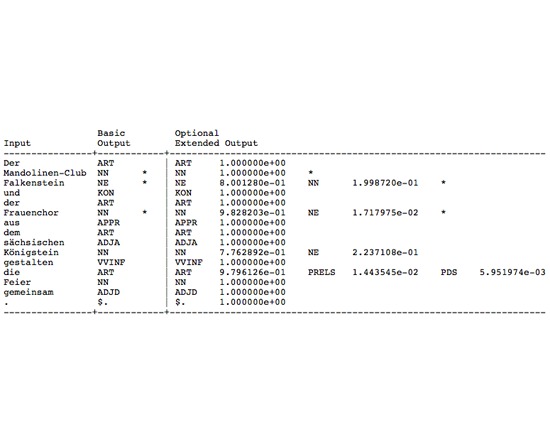
TnT, which is short for Trigrams'n'Tags, is a statistical part-of-speech tagger from Universitat de Saarlandes. It can be trained on a variety of corpora and languages, and is based on the Viterbi algorithm for second order Markov models. It includes language models for English and German. This program is only available on request.
Documentation
Creator(s): Thorsten Brants, Universitat de Saarlandes Computational Linguistics
Creator's Site: http://www.coli.uni-sb.de/
Creator's Email:
Repository:
Attributes
- Type of analysis: Natural Language Processing Analysis Content Analysis
- Type of license: Free
- Web Usable: Software you Download and Install
- Ease of Use: Moderate
- Historic Tool (developed before 2005): Development sustained to present
- TaDiRAH Goals: Analysis
- TaDiRAH Methods: Content Analysis Other (analysis) Statistical Analysis
List this tool appear on
Rating
Suggested Tools
Comments